사용 기록
써 본 날2026-10-17
도구Gemma 4 (구글 오픈 모델) + Ollama 0.40.5
컴퓨터맥미니 M4, 메모리 16GB
비용무료 (가입 없음)
설치필요 (터미널 명령 몇 줄)
해 본 것휴가 메일 쓰기, 글 요약, 사실 질문, 그림 속 표 옮기기
못 해 본 것8GB 맥·윈도 PC, 12B·26B·31B, 음성 입력, 인터넷 끊고 쓰기
한 줄 결론구글 오픈 모델 젬마 4를 올라마로 맥미니(M4, 메모리 16GB)에 깔아 봤어요. 가입도 결제도 없이 9.5GB를 받는 데 12분 걸렸고 첫 질문 뒤로는 한국어 답이 1초 안팎에서 20초 안쪽으로 나왔어요. 다만 모델 혼자 메모리를 9GB 넘게 써서 16GB 맥에서는 다른 작업과 같이 돌리기에 여유가 많지 않아요.
10월 17일 오후(한국 시각)에 맥미니에 구글 젬마 4를 깔고 한국어로 이것저것 시켜 봤어요. 맥미니는 M4 칩에 메모리 16GB짜리예요. 올라마(Ollama)라는 무료 프로그램으로 모델을 받았고 받는 데 12분이 걸렸어요. 처음 한 번은 답이 나오기까지 2분 가까이 기다렸지만 그다음부터는 휴가 메일 한 통이 14초, 생각하기를 건너뛴 짧은 답은 1초도 안 걸렸어요. 챗GPT·제미나이처럼 서비스에 가입해서 쓰는 게 아니라, 모델 파일을 내 맥에 받아 돌리는 방식이에요.
젬마 4가 뭔가요?
구글이 누구나 내려받아 쓸 수 있게 공개한 AI 모델이에요. 구글 개발자 문서의 출시 기록을 보면 2026년 3월 31일에 E2B, E4B, 26B A4B, 31B 네 가지 크기로 나왔고 6월 3일에 12B가 더해졌어요. 이름 앞의 E는 ‘실효(effective) 매개변수’라는 뜻이고 구글 문서는 E2B·E4B를 휴대폰(픽셀)·브라우저(크롬) 같은 기기용으로 소개해요.
라이선스는 Apache 2.0이에요. 구글 문서에는 “책임 있는 상업적 사용을 허용한다”고 적혀 있어요. 모델 파일을 받는 데 돈은 들지 않았어요.
맥에 어떻게 깔았나요?
올라마를 깔아서 켜 두고 모델 이름을 치면 돼요. 이번에 한 순서는 이래요.
- 터미널(명령어를 치는 창)을 연다
brew install ollama로 올라마를 깐다- 다른 터미널 창에서
ollama serve로 올라마를 켜 둔다(계속 켜 두려면brew services start ollama) ollama pull gemma4로 젬마 4를 내려받는다ollama run gemma4 "질문"으로 물어본다
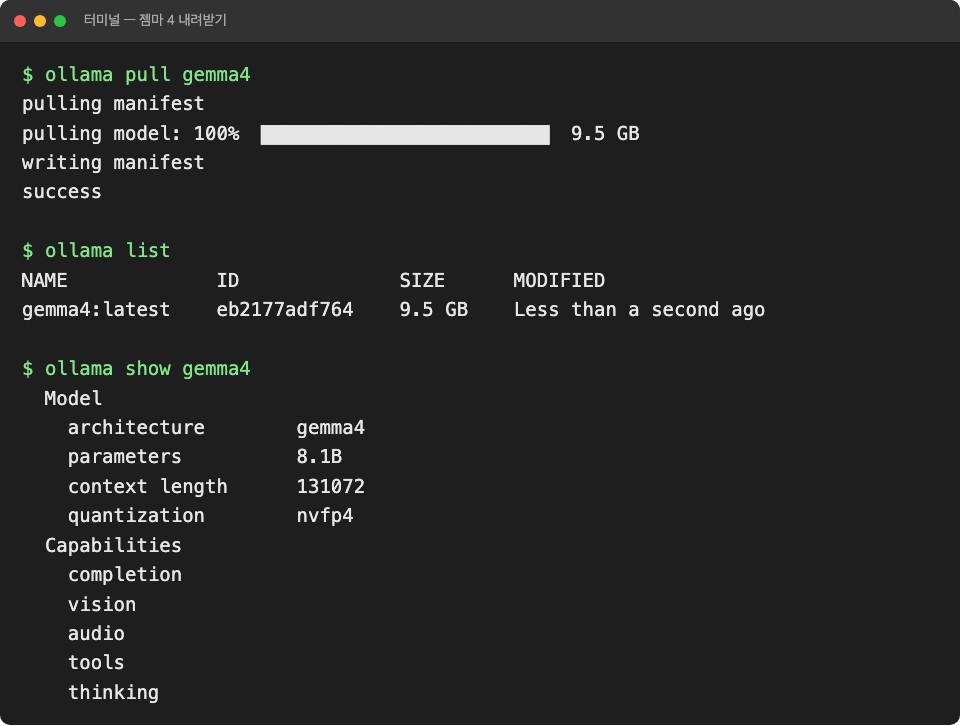
이번에는 맥에 이미 깔려 있던 홈브루(맥용 프로그램 설치 도구)로 올라마 0.40.5를 깔았어요. 받은 모델 정보에는 올라마 0.31.0 이상이 필요하다고 적혀 있었습니다. ollama.com의 맥용 앱으로 까는 방법은 이번에 해 보지 않았어요. 위 터미널 그림은 실제 출력 글자를 터미널 모양 그림으로 다시 옮긴 것이고 몇 줄은 줄였어요.
이름만 gemma4로 받으면 9.5GB짜리가 내려와요. 올라마 모델 페이지에는 이 기본 모델이 E4B와 같은 크기로 표시돼 있어요. 디스크에 10GB 넘게 여유가 있어야 해요. 받은 모델 정보를 보니 매개변수 81억 개, 한 번에 읽는 길이(문맥) 13만 1072 토큰, 할 수 있는 일에 글쓰기·그림 보기(vision)·음성(audio)·도구 쓰기·생각하기(thinking)가 적혀 있었어요. 받는 데는 12분(오후 2시 54분~3시 6분) 걸렸어요.
한국어로 시키면 쓸 만한가요?
네 가지를 시켜 봤어요.
- 휴가 메일: “다음 주 금요일에 연차를 쓰려고 해. 팀장님께 보낼 휴가 신청 메일을 정중하게 세 문장으로 써 줘.”
- 글 요약: 광합성 설명 한 문단을 주고 “초등학생도 이해하게 세 줄로 요약해 줘.”
- 사실 질문: “조선 시대 세종대왕이 훈민정음을 반포한 해는 몇 년이야? 한 문장으로 답해 줘.”
- 그림 읽기: “이 그림에 적힌 내용을 표로 정리해 줘. ./table.jpg”처럼 질문 끝에 그림 파일 경로를 붙임
휴가 메일은 세 문장은 지켰는데 한 통이 아니라 두세 벌을 ‘옵션 1, 옵션 2’처럼 나눠 써 줬어요. 문장은 “해당 날짜에 제가 맡은 업무에 차질이 없도록 미리 마무리하고 가겠습니다.” 같은 식이었습니다. 옵션 제목 앞에는 전구 이모지를 붙였어요.
요약은 세 줄로 나눠 줬어요. “식물은 햇빛 에너지를 가지고 물과 이산화탄소를 사용해서 스스로 먹을 음식(양분)을 만들어요.”처럼 초등학생 말투로 바꿨어요. 셋째 줄의 “지구상의 모든 생명이 살아갈 힘”은 원문(거의 모든 생물의 에너지원)보다 조금 넓게 말한 표현이었어요. 줄마다 이모지를 하나씩 붙였어요.
사실 질문은 맞히나요?
훈민정음 반포 연도를 여섯 번 물었더니 다섯 번은 “1446년”이라고 답했어요. 한 번은 “1443년에서 1446년 사이(혹은 1446년)에 반포되었습니다.”라고 했어요. 국가기록원 설명대로 1443년은 훈민정음을 만든 해, 1446년은 반포한 해라서 이 한 번은 두 해를 섞은 답이에요.
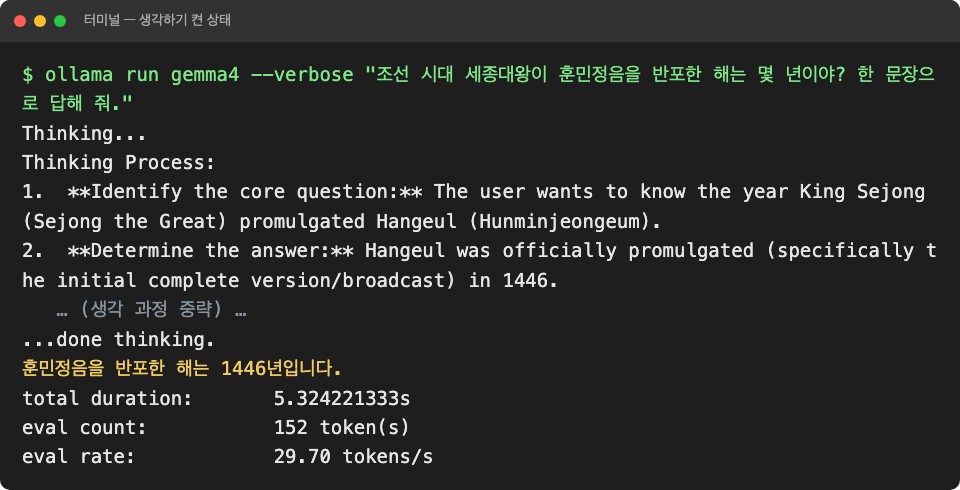
화면처럼 젬마 4는 답하기 전에 ‘생각하기’를 할 때가 많았어요. 질문은 한국어인데 생각 과정은 영어로 나왔어요. 생각하기는 기본으로 켜져 있지만 짧은 질문에는 생각 없이 바로 답한 회차도 있었어요. 터미널에서 끄려면 --think=false를 붙이면 돼요. 같은 휴가 메일을 올라마 API에서 생각하기를 끄고 시키니 14초에서 5초로 줄었어요.
그림 속 글자도 읽나요?
읽어요. 지난번 노트북LM 글에서 만든 광합성 비교표 그림을 주고 표로 옮겨 달라고 했어요. 작업 장소, 필요한 재료, 최종 생성물 세 줄을 칸까지 원본 그림과 같게 옮겼고 4초 걸렸어요.
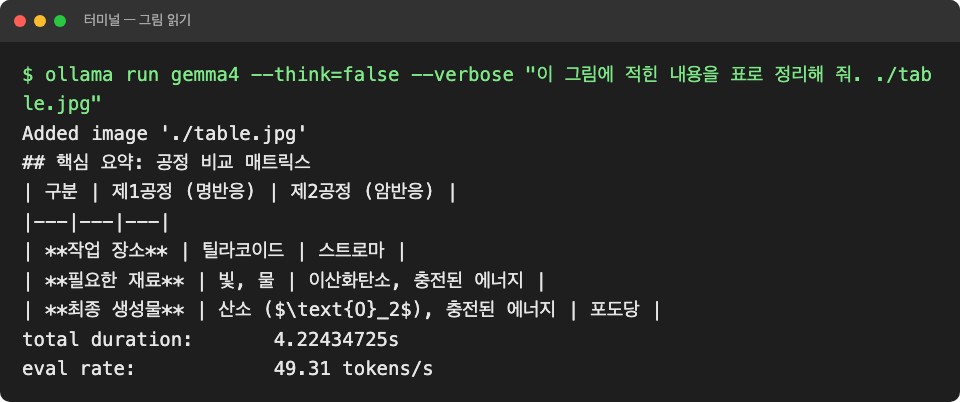
터미널에서는 산소가 $text{O}_2$처럼 수식 기호 그대로 찍혀 나왔어요. 수식을 그림으로 보여 주는 화면에 붙여 넣어야 O₂로 보여요.
16GB 맥에서 버거운가요?
돌아가긴 하는데 여유가 많지는 않았어요. ollama ps로 보니 젬마 4가 메모리를 9.4~9.6GB 쓰고 있었고, 모델이 맥의 그래픽 칩(GPU)에 전부 올라간 것으로(100% GPU) 표시됐어요. 이 맥미니에는 다른 작업도 여러 개 함께 돌고 있어서, 모델을 올리기 직전과 직후 몇 초 사이를 따로 재 봤어요. 맥 여유 메모리는 81%에서 12%로 내려갔고, 맥이 고정으로 잡아 두는 메모리(wired)는 1.9GB에서 11.0GB로 9.1GB 늘었어요. 모델을 내리자 여유 메모리는 76%로 돌아왔어요.
속도는 1초에 30~64토큰(모델이 글을 만드는 단위)이었어요. 처음 한 번은 모두 1분 57초가 걸렸는데, 모델을 올리는 데 24.6초, 질문을 읽어 들이는 데 1분 13초가 들었어요. 그다음부터는 답을 다 받기까지 1초 안팎에서 20초 안쪽이었어요.
구글 문서에 나온 모델별 메모리(4비트 기준, 모델 파일만 올렸을 때의 어림값이고 대화가 길어질수록 더 듦)는 E2B 2.9GB, E4B 4.5GB, 12B 6.7GB, 26B 14.4GB, 31B 17.5GB예요. 이번에 올라마로 받은 기본 모델은 방식이 다른 압축(nvfp4)이라 실제로는 9GB 넘게 썼어요. ollama ps에 문맥이 4096으로 나왔으니, 모델 정보의 최대 13만 토큰까지 쓰면 더 늘어날 거예요. 12B·26B·31B는 이번에 돌려 보지 않았습니다.
더 작은 E2B는 어떤가요?
같은 질문을 gemma4:e2b로도 시켜 봤어요. 받는 파일은 7.5GB였고, 모델 정보에는 매개변수 52억 개로 나왔어요. 돌리는 동안 모델 혼자 메모리를 7.4GB 썼어요. 같은 방법으로 올리기 직전·직후를 재 보니 맥 여유 메모리는 77%에서 25%로, 고정 메모리는 6.7GB 늘었어요.
- 속도: 1초에 67~76토큰으로 기본 모델보다 빨랐어요. 휴가 메일이 생각하기를 켜고 5.7초, 끄고 2.4초였어요
- 휴가 메일: 생각하기를 켰을 때는 세 문장짜리 한 벌만 써 줬어요. 다만 “팀장님의 승인해주시면 감사하겠습니다.”처럼 조사가 어색한 문장이 하나 있었어요
- 사실 질문: “세종대왕은 1446년에 훈민정음을 반포했습니다.”라고 맞혔어요(한 번 물음)
- 그림 읽기: 여기서 차이가 컸어요. 작업 장소 칸에 “작업 장소”를 그대로 넣었고, 틸라코이드를 “빌라코이드”로 잘못 읽어 필요한 재료 칸에 넣었어요. 이산화탄소, 빛, 물을 한 칸에 몰아넣기도 했어요
짧은 글쓰기는 E2B로도 됐지만, 이번 표 그림을 옮기는 일은 기본 모델이 정확했고 E2B는 틀렸어요.
직접 써 보니 어땠나요?
가입 없이 명령 몇 줄로 한국어 답을 하는 AI가 내 맥에서 돌아갔어요. 휴가 메일, 요약, 그림 속 표 옮기기 모두 기본 모델에서는 시킨 대로 나왔어요. 모델은 내 맥에서 돌았지만, 통신을 따로 점검하지는 않았어요.
대신 사실 질문은 여섯 번 중 한 번 두 해를 섞었고, 메일은 한 통이 아니라 여러 벌로 나왔어요. 메모리도 모델 혼자 9GB 넘게 써서, 16GB 맥에서 다른 작업과 같이 돌리기엔 여유가 많지 않았어요. 인터넷을 끊고도 되는지는 이번에 확인하지 않았어요.
함께 읽을 글
- 코덱스가 맥 용량을 잡아먹는다는 Crashpad, 제 맥에서 확인해 보니 0개였어요
- 노트북LM으로 PPT 만들어 보니, 받은 파일은 통그림이었어요
- 제미나이 4 아르곤, 무료로는 못 써요: 앱은 프로부터
- 앱 뜯어보는 AI 도구 REA, 깃허브 별 32만 개보다 먼저 볼 것
- 미니맥스 M3.1 플래시 써 보니, 없는 도시 인구를 지어냈어요
2026년 10월 17일 기준.
참고한 자료