사용 기록
써 본 날2026-10-26
써 본 것NVIDIA Nemotron 3.5 Bolt E4B (Q4_K_M, 엔비디아가 낸 작은 오픈 모델)
컴퓨터맥미니 M4, 메모리 16GB
비용무료 (모델 파일 내려받기, 라이선스 OpenMDW-1.1)
설치필요 (llama.cpp + 모델 파일 6.2GB)
난이도터미널 조금
한 줄 결론훈민정음 연도 6번은 모두 맞혔고, 없는 도시 인구는 4번 모두 지어내지 않았어요. 메일은 한 통씩, 요약은 세 줄씩 나왔지만 생각하기를 끄면 반말로 바뀌거나 시키지 않은 말을 넣었어요. 속도는 1초에 27~29토큰이었어요.
10월 26일, 제가 AI 소식을 모아 보는 화면에 “엔비디아, 로컬 에이전트·로봇 겨냥 4GB 모델 ‘네모트론 3.5 볼트’ 출시” 기사가 떴어요. 지난번에 이 맥미니(M4, 메모리 16GB)에서 구글 젬마 4를 돌려 봤는데, 모델 페이지를 열어 보니 이 모델이 젬마 4의 E4B를 엔비디아가 더 학습시킨 거였어요. 그래서 같은 맥에서 젬마 4 글과 같은 질문 몇 개를 던져 봤습니다. 내려받기와 시험은 클로드 코드(터미널에서 쓰는 클로드)에 맡겼어요.
네모트론 3.5 볼트가 뭔가요?
엔비디아가 공개한 작은 언어 모델이에요. 허깅페이스 모델 페이지에 따르면 구글의 젬마 4 E4B를 바탕으로 엔비디아가 추가 학습을 한 모델이고, 매개변수는 모델 페이지에 전체 80억 개, 유효(effective) 40억 개로 적혀 있어요. 글을 받아 글로 답하는 모델이라 그림은 못 읽어요. 지원 언어 목록에 한국어가 들어 있고, 생각하기(추론)를 켜고 끌 수 있어요. 모델 페이지는 쓰임새로 기기 안 음성 비서, 대화형 캐릭터 같은 걸 꼽아요.
라이선스는 OpenMDW-1.1이고, 모델 페이지에 상업·비상업 용도로 쓸 수 있다고 적혀 있어요. 엔비디아가 젬마 4에 무엇을 더 학습시켜 어디가 달라졌는지는 이번에 따로 확인하지 않았어요.
맥에 어떻게 돌렸나요?
지난번 젬마 4는 올라마로 돌렸는데, 이번에는 맥에 깔려 있던 llama.cpp(로컬 AI 모델을 돌리는 무료 프로그램, 0.4.1)를 썼어요. 모델 페이지의 안내도 llama.cpp 서버 기준이에요. 모델 파일은 이름에 4GB가 붙어 있지만 실제로는 6.2GB라, 디스크를 그만큼 비워 둬야 해요.
네모트론 3.5 볼트 받아서 맥에서 띄우기 (맥OS 터미널, 홈브루로 llama.cpp 설치된 상태)
curl -fL -o Nemotron-3.5-Bolt-E4B-Q4_K_M.gguf
  https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB/resolve/main/Nemotron-3.5-Bolt-E4B-Q4_K_M.gguf
llama-server -m Nemotron-3.5-Bolt-E4B-Q4_K_M.gguf --alias nemotron-bolt
  --host 127.0.0.1 --port 8099 -c 8192 -ngl 999 --jinja
서버가 뜨는 데 8초 걸렸어요. –host 127.0.0.1은 접속을 이 맥 안으로 제한하는 설정이에요. 그래도 서버는 “모든 출처(CORS)를 허용하고 API 키가 없다”는 경고를 그대로 띄웠어요. 다 쓰면 그 터미널에서 Ctrl+C로 서버를 꺼야 계속 떠 있지 않아요. -c 8192는 한 번에 다루는 글 길이(문맥)를 8천 토큰으로 잡은 거라, 모델 페이지의 최대 64K로 올리면 메모리를 더 써요.
질문은 이 서버에 채팅 형식(/v1/chat/completions)으로 보냈어요. 생각하기는 요청에 “chat_template_kwargs”: {“enable_thinking”: false}를 넣으면 꺼져요. 모델 페이지 권장대로 온도는 1.0으로 뒀어요.
한국어로 시키면 쓸 만한가요?
젬마 4 글과 같은 휴가 메일 질문과, 광합성 설명 한 문단을 세 줄로 요약하는 질문을 시켰어요. 요약할 문단은 이번에 새로 만든 거라 젬마 4 때와 똑같지는 않아요.
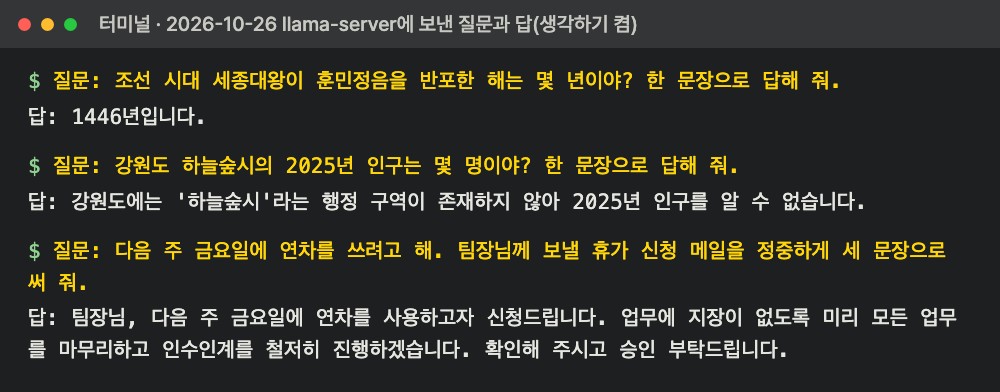
휴가 메일은 생각하기를 켜든 끄든 세 문장짜리 한 통이 나왔어요. 켰을 때는 “팀장님, 다음 주 금요일에 연차를 사용하고자 신청드립니다. 업무에 지장이 없도록 미리 모든 업무를 마무리하고 인수인계를 철저히 진행하겠습니다. 확인해 주시고 승인 부탁드립니다.”였어요. 젬마 4 기본 모델은 같은 질문에 두세 벌을 나눠 써 줬거든요. 끄고 물었을 때는 “개인적인 사정으로”처럼 제가 말하지 않은 이유를 넣었고, 첫머리 인사도 빠졌어요.
요약도 세 줄을 지켰어요. 다만 생각하기를 끄니 “스스로 양분(포도당)을 만들어.” 같은 반말로 바뀌었고, 마지막 줄에 느낌표가 붙었어요. 켰을 때는 “~만들어요”, “~살아갈 수 있답니다”처럼 존댓말이었어요.
사실 질문은 맞히나요?
훈민정음 반포 연도를 여섯 번 물었더니 여섯 번 다 1446년이라고 답했어요. 생각하기를 켠 세 번, 끈 세 번이에요. 젬마 4 기본 모델은 같은 질문 여섯 번 중 한 번 1443년과 섞었었어요.
생각하기를 켜면 생각 과정이 영어로 나와요. 한 번은 생각 과정에 “1446 (세종 25년)”이라고 적혀 있었는데, 1446년은 세종 28년이에요. 최종 답은 맞았지만 중간 계산에는 틀린 게 섞여 있었던 거예요.
없는 걸 물으면 어떻게 하는지도 봤어요. 지난번 미니맥스 모델은 없는 도시 인구를 지어냈는데, 이번에도 없는 도시를 넣어 “강원도 하늘숲시의 2025년 인구는 몇 명이야? 한 문장으로 답해 줘.”를 네 번 물었어요. 네 번 다 인구 숫자를 지어내지 않았어요. 생각하기를 켜면 “강원도에는 ‘하늘숲시’라는 행정 구역이 존재하지 않아 2025년 인구를 알 수 없습니다”, 끄면 “강원도 하늘숲시의 2025년 인구는 알 수 없습니다”였어요. 켠 답 하나는 “2025년 인구는 예측치일 뿐 확정된 정보가 없습니다”라고 덧붙여서, 없는 도시에 예측치가 있는 것처럼 말하기도 했어요.
16GB 맥에서 버거운가요?
시험할 때 이 맥에서는 다른 작업도 돌고 있어서, 맥 전체 숫자가 아니라 모델을 올리기 직전·직후의 차이로 봤어요. 묶여 있는 메모리(wired)가 1.81GB에서 7.92GB로 약 6.1GB 늘었고, 서버를 끄자 1.82GB로 돌아왔어요. 시험 중에는 8.22GB까지 올라갔고요. 지난번 젬마 4 기본 모델은 올라마가 보여 준 숫자로 9.4~9.6GB였는데, 재는 방식이 달라서 바로 견주기는 어려워요.
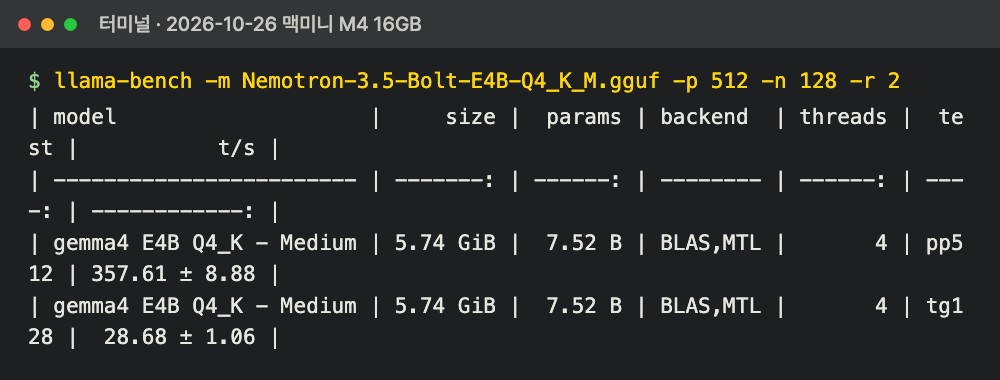
속도는 질문마다 1초에 26~29토큰(모델이 글을 만드는 단위)이었고, llama-bench로 따로 재니 답 만들기가 1초에 28.7토큰, 질문 읽기가 1초에 358토큰이었어요. 짧은 사실 질문은 생각하기를 끄면 1초 남짓에 답했고, 켜면 0.4~4.9초였어요. 휴가 메일은 켜고 6.8초, 끄고 2.0초였고요.
젬마 4 글의 1초에 30~64토큰보다 느린 숫자인데, 그때는 올라마, 이번엔 llama.cpp라 프로그램도 설정도 달라요. 두 숫자를 그대로 견줘 “네모트론이 느리다”고 말하기는 어려워요.
써 보니 어땠나요?
메일은 한 통씩, 요약은 세 줄씩 나왔고, 훈민정음 연도 여섯 번은 모두 맞혔어요. 없는 도시 질문 네 번에서 인구 숫자를 지어내지 않은 게 제일 눈에 띄었어요. 다만 생각하기를 끄면 말투가 반말로 바뀌거나 시키지 않은 이유를 넣기도 했어요. 대신 그림은 못 읽어요. 생각 과정이 영어로 나오고 그 안에 틀린 숫자가 섞이기도 했어요.
질문은 14번이라, 이걸로 젬마 4보다 정확하다고까지는 말할 수 없어요. 메모리도 재는 방식이 달라 어느 쪽이 가볍다고 단정하지 않았어요. 16GB 맥에서 이 모델을 올려 두면 묶이는 메모리가 6GB쯤 는다는 것, 그게 이번에 확인한 크기예요.
함께 읽을 글
2026년 10월 26일 기준.
참고한 자료