사용 기록
써 본 날2026-11-11
써 본 것코덱스 CLI 0.167.0에서 GPT-6 아스트라와 GPT-6.1 솔, 추론 수준 low, 같은 지시문 세 가지
비용챗GPT 구독 안의 코덱스 사용량. API로 쓰면 아스트라가 솔의 5배(오픈AI 문서)
설치없음 (코덱스 CLI에서 -m 으로 모델만 바꿈)
회사 자료쓰지 않음
난이도터미널 조금
결과날짜 함수: 둘 다 자기 시험 통과, 시험을 바꿔 돌리니 솔 코드만 2개 실패. 쉬운 문장·버그 찾기: 둘 다 같은 답. 시간은 솔이 조금 빨랐음
한 줄 결론세 가지 중 날짜 함수에서만 갈렸고, 아스트라가 입력 형식 검사를 하나 더 넣었어요. API 값은 5배예요.
제 맥미니에서는 코덱스를 매일 써요. 기본 모델은 GPT-6.1 솔로 잡아 두었어요. 그런데 코덱스에는 오픈AI가 가장 성능이 좋다고 소개하는 GPT-6 아스트라도 있어요.
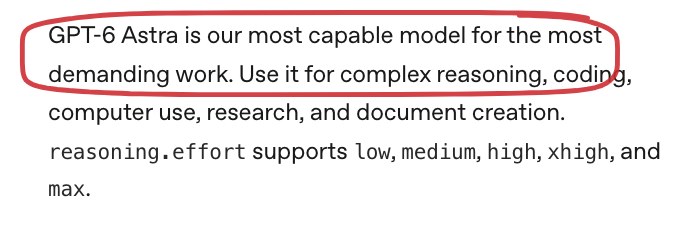
솔은 문서에서 “아스트라에 가까운 성능을 더 낮은 값에”라고 소개돼요. 그러면 실제로 같은 일을 시켰을 때 무엇이 다른지, 나란히 시켜 봤어요.
코덱스에서 아스트라를 쓰려면?
코덱스 CLI에서 모델 이름만 바꾸면 돼요. codex exec -m gpt-6-astra처럼 -m 뒤에 gpt-6-astra를 넣었더니 제 챗GPT 구독 계정에서 바로 돌았어요. 솔은 gpt-6.1-sol이에요. 둘 다 추론 수준은 제 설정대로 low였어요.
값은 많이 달라요. 오픈AI 문서 기준 100만 토큰당 아스트라는 입력 10달러·출력 50달러, 솔은 입력 2달러·출력 10달러예요. API로 쓰면 입력·출력 값이 5배고, 캐시에서 읽는 입력은 1달러와 0.1달러라 10배예요. 컨텍스트 창은 둘 다 105만 토큰이에요.
같은 일 세 가지를 어떻게 시켰나요?
첫째는 코드예요. “‘YYYY-MM-DD’ 두 날짜 사이 평일 수를 세는 함수를 만들고, 경계 사례 5개 이상의 시험을 짜서 통과시켜라”라고 시켰어요. 시작일이 종료일보다 늦으면 오류를 내라는 조건도 넣었어요.
둘째는 한국어예요. 건강보험료 설명 문단을 “초등학교 5학년이 이해하게 세 문장으로, 숫자는 그대로” 바꾸게 했어요. 셋째는 버그 찾기예요. 버그 두 개를 심은 10줄짜리 쪽 나누기 함수를 주고 모두 찾아 고치게 했어요. 세 가지 모두 두 모델에 같은 지시문을 빈 폴더에서 한 번씩 보냈어요.
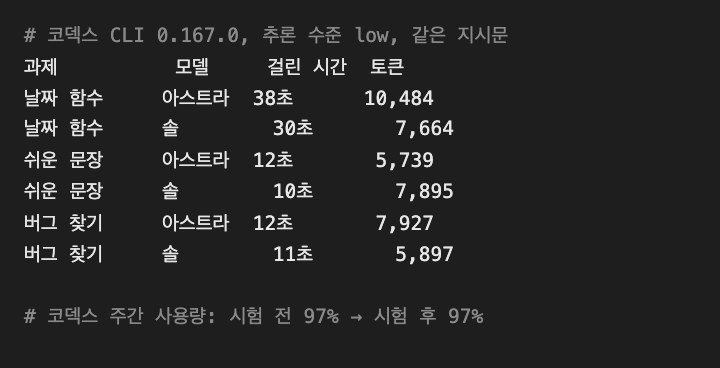
여섯 번 시키는 동안 제 코덱스 주간 사용량 표시는 시험 전후 모두 97%였어요. 그래서 구독 안에서 아스트라가 사용량을 얼마나 더 빨리 쓰는지는 이번 시험으로 알 수 없었어요.
시간은 솔이 조금씩 빨랐어요. 날짜 함수는 아스트라 38초·솔 30초, 문장 바꾸기는 12초·10초, 버그 찾기는 12초·11초였어요. 토큰은 일마다 달라서, 날짜 함수와 버그 찾기는 아스트라가 더 썼고 문장 바꾸기는 솔이 더 썼어요.
날짜 함수는 어디서 갈렸나요?
둘 다 자기가 짠 시험은 통과했어요. 아스트라는 12개, 솔은 11개였어요.
코드도 거의 같았어요. 둘 다 날짜 사이 일수를 7일 묶음으로 나눠 묶음마다 평일 5일을 더하고, 남은 며칠만 요일을 하나씩 세는 방식이었어요. 함수 길이도 아스트라 21줄, 솔 16줄로 비슷했어요.
시험 목록은 달랐어요. 둘 다 하루짜리 기간(평일·토요일·일요일), 주말만 낀 기간, 한 주 전체, 해 넘김, 윤년, 순서가 뒤집힌 기간, 파이썬이 다루는 가장 늦은 날짜까지 챙겼어요. 아스트라는 여기에 “잘못된 형식” 묶음을 하나 더 넣었어요. 없는 날짜인 2026-02-29, 하이픈 없는 20261111, 한 자리 월인 2026-1-1, 아예 날짜가 아닌 글자예요.
그래서 시험을 바꿔 돌렸어요. 아스트라 코드에 솔의 시험을, 솔 코드에 아스트라의 시험을 넣었어요.
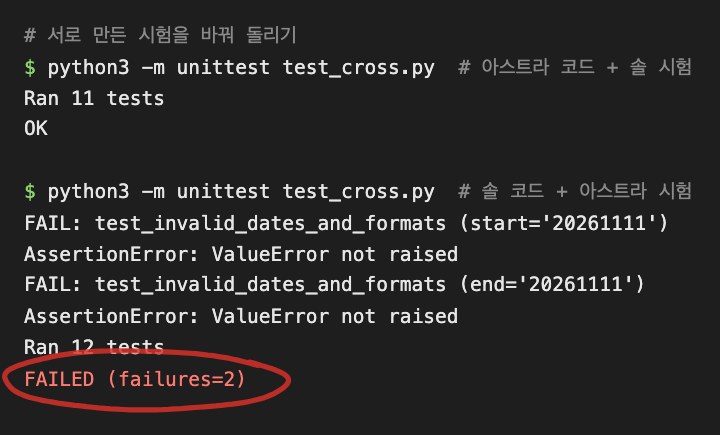
솔 코드만 2개가 실패했어요. 솔의 시험에는 형식 검사 항목이 없어서, 아스트라 코드는 솔 시험을 모두 통과했어요. 형식 검사를 시험에 넣은 것도, 코드에 넣은 것도 아스트라 쪽이었던 셈이에요. 아스트라의 시험에는 ‘20261111’처럼 하이픈 없는 날짜를 넣으면 오류가 나야 한다는 항목이 있었는데, 솔 코드는 이걸 그냥 받아들였어요.
이유는 파이썬에 있어요. 제 맥의 파이썬은 3.14인데, 이 버전의 날짜 읽기 함수(date.fromisoformat)는 ‘20261111’ 같은 붙여 쓴 형식도 날짜로 읽어 줘요. 반면 2026-02-29나 2026-1-1은 함수가 알아서 거절해서, 솔 코드도 이 두 가지는 통과했어요. 지시문은 ‘YYYY-MM-DD’ 형식이라고 했는데, 아스트라는 읽은 날짜를 다시 그 형식으로 바꿔 원래 글자와 같은지 한 번 더 확인했어요. 솔은 이 확인이 없었어요.
쉬운 문장 바꾸기는요?
여기는 차이가 작았어요. 둘 다 “해마다 11월분부터 새 자료로 다시 계산해요”로 시작해 세 문장으로 끝냈고, 7.19%와 6월 1일, 10월분 같은 숫자를 그대로 지켰어요.
표현만 조금 달랐어요. 아스트라는 “한 해 더 최근 자료로 바뀌었기 때문”이라고 했고, 솔은 보험료율을 “보험료를 계산할 때 쓰는 비율인 7.19%”로 풀어 썼어요.
버그 찾기는요?
함수에 심은 버그는 두 개였어요. 쪽 번호가 1부터인데 시작 위치를 page * size로 잡아 한 쪽씩 밀리는 것, 전체 쪽 수를 내림으로 계산해 남은 항목이 있는 마지막 쪽이 빠지는 것이에요.
둘 다 두 개를 모두 찾았고, 고친 함수는 한 글자도 다르지 않았어요. 시작 위치를 (page - 1) * size로, 전체 쪽 수를 올림 계산 (len(items) + size - 1) // size로 바꿨어요. 설명 문장만 조금 달랐을 뿐이에요.
그래서 아스트라는 언제 쓰면 되나요?
결론은 세 가지 일 중 한 가지에서만 차이가 났다는 거예요. 날짜 함수에서는 아스트라가 지시문의 형식 조건까지 코드와 시험에 넣었고, 문장 바꾸기와 버그 찾기는 둘이 같은 수준이었어요. 시간은 솔이 조금씩 빨랐어요.
과제마다 한 번씩 시킨 결과라, 이것만으로 아스트라가 늘 더 정확하다고 할 수는 없어요. 분명한 건 API로 쓰면 값이 5배라는 점이고, 구독 안에서 사용량을 얼마나 더 쓰는지는 이번에 확인하지 못했어요. 형식·경계 조건이 중요한 코드에서 두 모델 답을 나란히 놓고 볼 때 아스트라가 한 가지를 더 챙긴 사례로 남겨 둬요.
함께 읽을 글
2026년 11월 11일 기준.
참고한 자료