사용 기록
다시 써 본 날2026-11-02
써 본 것클로드 하이쿠·소넷·오퍼스 5.5 (클로드 코드), GPT-6.1 솔·테라 (코덱스 CLI)
비용쓰던 클로드·코덱스 정액 요금제 안에서 잼
설치필요 (터미널에서 쓰는 클로드 코드·코덱스)
회사 자료쓰지 않음 (제 블로그 글 한 대목)
난이도터미널 조금
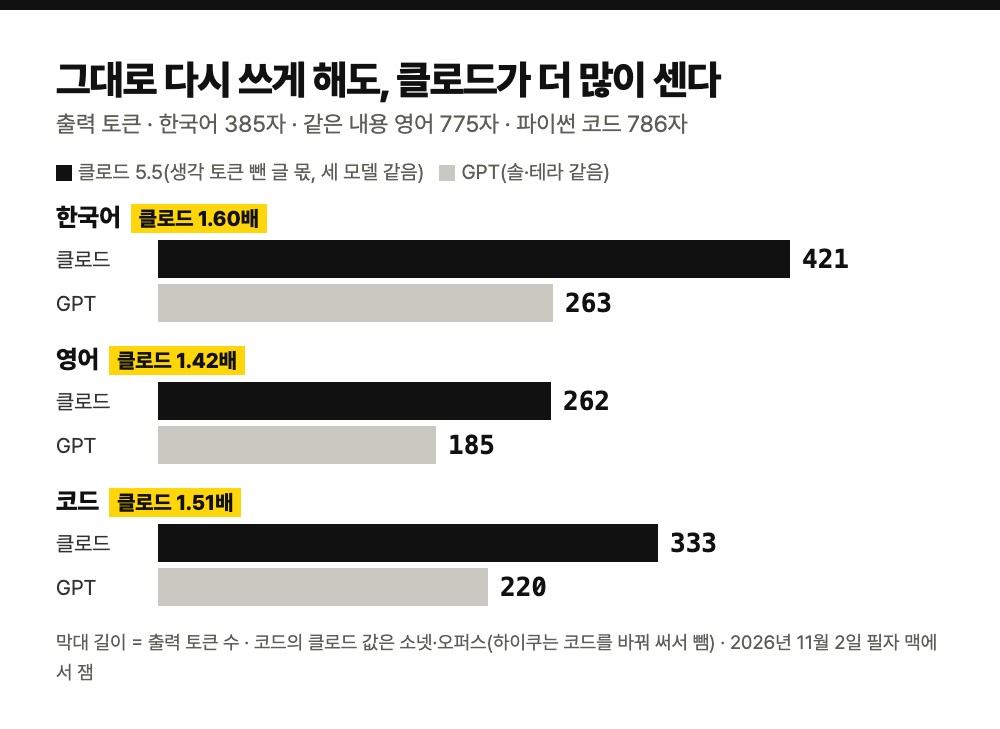
결과한국어 클로드 421토큰, GPT 263토큰. 영어는 262 대 185, 코드는 333 대 220
한 줄 결론모델이 써 내는 쪽에서도 한국어는 클로드가 1.6배 많은 토큰으로 세졌어요. 한국어 글을 그대로 쓸 때 하이쿠와 오퍼스에는 생각 토큰이 26~81개 더 붙었어요.
지난 글에서 같은 한국어 글을 클로드와 GPT에 넣고 입력 토큰을 쟀어요. 클로드가 1.6배였어요. 그 글 끝에 “출력은 이번에 재지 않았다”고 적어 뒀거든요. 11월 2일에 그 빈칸을 쟀어요.
출력 토큰은 어떻게 재요?
모델마다 답이 달라서 그냥 질문하고 답을 비교하면 공정하지 않아요. 한쪽이 길게 쓰면 토큰이 많을 수밖에 없거든요. 그래서 같은 글을 “한 글자도 바꾸지 말고 그대로 다시 써” 달라고 했어요. 그러면 두 모델이 똑같은 글자를 써 내요. 출력 토큰에서 생각 토큰을 뺀 값을 아래에서 “글 몫”이라고 부를게요. 글 몫끼리 비교하면 차이는 글을 자르는 방식 쪽으로 좁혀져요.
글은 지난번과 똑같은 세 가지예요. 한국어 385자, 같은 내용을 영어로 옮긴 775자, 파이썬 코드 786자예요.
그대로 다시 쓰게 하고 출력 토큰 보기 (맥OS 터미널, 2026-11-02)
claude -p --model claude-sonnet-5-5 --output-format json --tools "" "아래 글을 한 글자도 바꾸지 말고 그대로 다시 써. 앞뒤에 다른 말은 붙이지 마.

(여기에 글)"
codex exec --json -m gpt-6.1-sol "아래 글을 한 글자도 바꾸지 말고 그대로 다시 써. 앞뒤에 다른 말은 붙이지 마. 도구는 쓰지 마.

(여기에 글)" < /dev/null
클로드 코드는 결과의 usage 칸에 output_tokens를, 코덱스는 turn.completed 줄에 output_tokens를 알려 줘요. 생각 토큰은 따로 적혀 있어서 같이 봤어요. 모델마다 두 번씩 쟀고, 매번 써 낸 글이 원래 글과 한 글자도 다르지 않은지 비교했어요.
처음 한 번은 잘못 쟀어요. 코덱스 쪽 “도구는 쓰지 마.”를 글 뒤에 붙였더니, 솔이 그 문장까지 글로 알고 따라 썼어요. 그래서 지시를 전부 글 앞으로 옮기고 다시 쟀어요. 아래 숫자는 다시 잰 값이에요.
결과: 출력도 한국어는 클로드가 1.6배
- 클로드 5.5: 한국어 421, 영어 262, 코드 333토큰
- GPT-6.1 솔·테라: 한국어 263, 영어 185, 코드 220토큰
소넷과 GPT 두 모델은 두 번 잰 값이 같았어요. 하이쿠와 오퍼스는 생각 토큰이 붙어서 출력 값이 매번 달랐는데, 생각 토큰을 뺀 글 몫은 소넷과 같았어요. 다만 하이쿠는 코드 글을 두 번 다 조금 바꿔 써서 원래보다 14자 길어졌어요. 그래서 코드 칸의 클로드 값은 소넷·오퍼스 값이에요.
입력 때와 거의 같아요. 지난번 입력은 한국어 420 대 259, 영어 261 대 181, 코드 332 대 216이었어요. 이번 출력은 세 글 모두 클로드가 1개, GPT가 4개씩 더 많았어요. 이 몇 개가 무엇인지는 확인하지 못했어요. 그 몇 개를 빼면 같은 글을 읽을 때와 써 낼 때의 토큰 수가 같았어요.
그대로 베끼는데 생각 토큰은 왜 붙어요?
이번에 생각지 못한 숫자가 하나 나왔어요. 하이쿠와 오퍼스는 그대로 다시 쓰는 일에도 생각 토큰이 붙었어요.
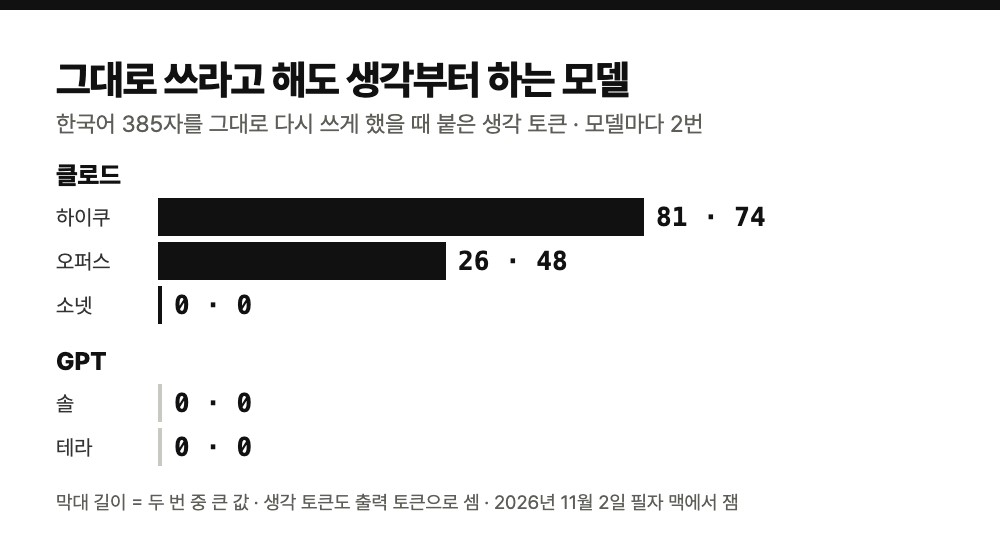
생각 토큰은 답을 쓰기 전에 모델이 속으로 따져 보는 데 쓴 토큰이에요. 화면에는 안 보이지만 출력 토큰에 같이 셈해요. 그래서 오퍼스 한국어 출력은 글 몫 421에 생각 26을 더한 447, 다른 한 번은 469로 찍혔어요.
생각 토큰은 클로드 코드와 코덱스를 기본 설정 그대로 쓴 값이에요. 붙는 양도 들쭉날쭉했어요. 하이쿠 영어는 한 번은 0, 한 번은 215였어요. 코드는 197과 227이었어요. 소넷과 솔·테라는 모델마다 여덟 번씩 부른 동안 모두 0이었어요.
돈으로 치면요?
출력 단가는 소넷 5.5와 솔이 100만 토큰당 10달러로 같아요. 한국어 1만 자를 써 내게 한다고 치고 이번 385자 비율로 늘리면, 클로드는 약 10,900토큰, GPT는 약 6,800토큰이에요.
- 소넷 5.5: 약 0.109달러
- 솔: 약 0.068달러
1,000번이면 소넷 약 109달러, 솔 약 68달러예요. 출력 단가는 입력의 5배라서, 같은 1.6배라도 출력 쪽에서 벌어지는 돈이 더 커요. 오퍼스나 하이쿠라면 여기에 생각 토큰이 더 붙을 수 있어요. 다만 테라(출력 5달러)나 하이쿠(0.5달러)처럼 단가 자체가 낮은 모델도 있어서, 모델끼리 비용은 단가와 같이 봐야 해요.
실제 답은 이번처럼 같은 글이 아니에요. 같은 질문에도 모델마다 답 길이가 달라요. 출력 비용은 써 낸 글의 토큰 수, 생각 토큰 수, 모델별 출력 단가에 따라 달라져요. 이번 측정은 세 글을 그대로 베낄 때만 모델마다 두 번씩 잰 거라, 평소 답의 글자당 토큰 수나 생각 토큰이 얼마나 자주 붙는지를 대표하지는 못해요.
정액 요금제와는 다른 이야기예요
지난 글과 마찬가지로 이 숫자는 API처럼 토큰마다 돈을 내는 경우의 이야기예요. 한 달 정액 요금제라면 이 숫자로 어느 쪽이 더 오래 버티는지 말할 수 없어요. 요금제 한도는 토큰 몇 개라고 공개돼 있지 않고, 한 일을 몇 번 오가서 끝내는지도 모델마다 달라요.
함께 읽을 글
- 같은 한국어 글을 넣어 보니, 클로드는 GPT보다 토큰이 1.6배 나왔어요
- 클로드 하이쿠 5.5 90% 인하, 무엇과 비교한 걸까
- GPT-6.1 테라 써 보니, 테트리스와 프로그래밍 언어까지 솔·소넷·오퍼스와 같은 시험을 가장 빨리 통과했어요
2026년 11월 2일 기준.
참고한 자료